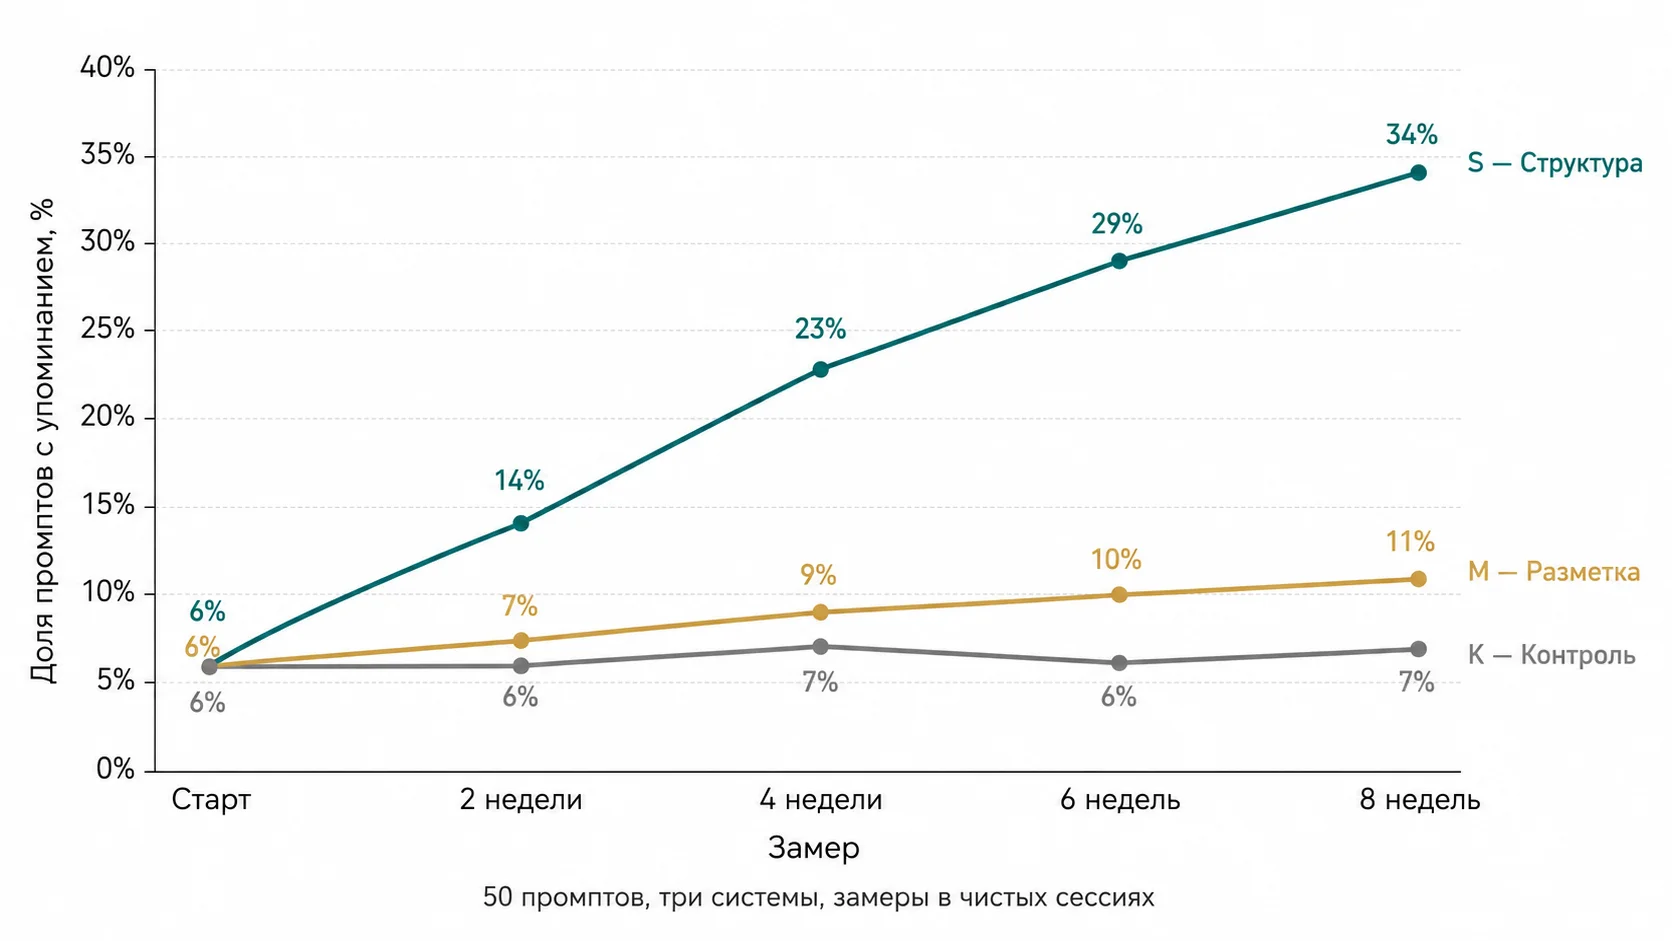
Шестьдесят страниц разбили на три группы. Одной добавили только schema.org, другой — определения, FAQ и таблицы, третью не трогали. За восемь недель доля промптов с упоминанием домена выросла с 6% до 34% в группе со структурой и всего до 11% в группе с одной разметкой.
Гипотеза
Вокруг попадания в ответы нейросетей сложились два конкурирующих объяснения. Первое: нужна структурированная разметка, schema.org «регистрирует» сущность и модель её видит. Второе: моделям безразлична разметка, они работают с текстом, и значение имеет то, насколько легко из текста извлечь законченное утверждение.
Проверяемая формулировка: на цитируемость в нейроответах сильнее влияет извлекаемость структуры в самом тексте — короткое определение, вопросно-ответные блоки, таблицы сравнения, явные источники, — чем наличие микроразметки при неизменном тексте.
Оговорка, без которой эксперимент невозможен: он требует, чтобы краулеры соответствующих систем имели доступ к сайту. Если в robots.txt или в настройках CDN закрыты OAI-SearchBot, ClaudeBot, PerplexityBot и подобные, замер покажет ноль во всех группах, и это будет говорить о настройках доступа, а не о качестве контента. Доступ проверяется до старта, а не после.
Условия и площадка
Площадка — сайт-4, B2B-услуги в сфере логистики. Раздел сайт-4/baza-znanij/ содержит 60 страниц справочного характера, по одному понятию или процессу на страницу. Формат подходит для задачи: такие страницы и так отвечают на вопрос, вопрос лишь в том, как именно.
Страницы случайным образом разбиты на три группы по 20, с балансировкой по текущему трафику и позициям:
| Группа | URL-шаблон | Что меняли |
|---|---|---|
| S — структура | сайт-4/baza-znanij/termin-01…20/ | Определение + FAQ + таблица + источники + schema |
| M — разметка | сайт-4/baza-znanij/termin-21…40/ | Только schema.org, текст не тронут |
| K — контроль | сайт-4/baza-znanij/termin-41…60/ | Без изменений |
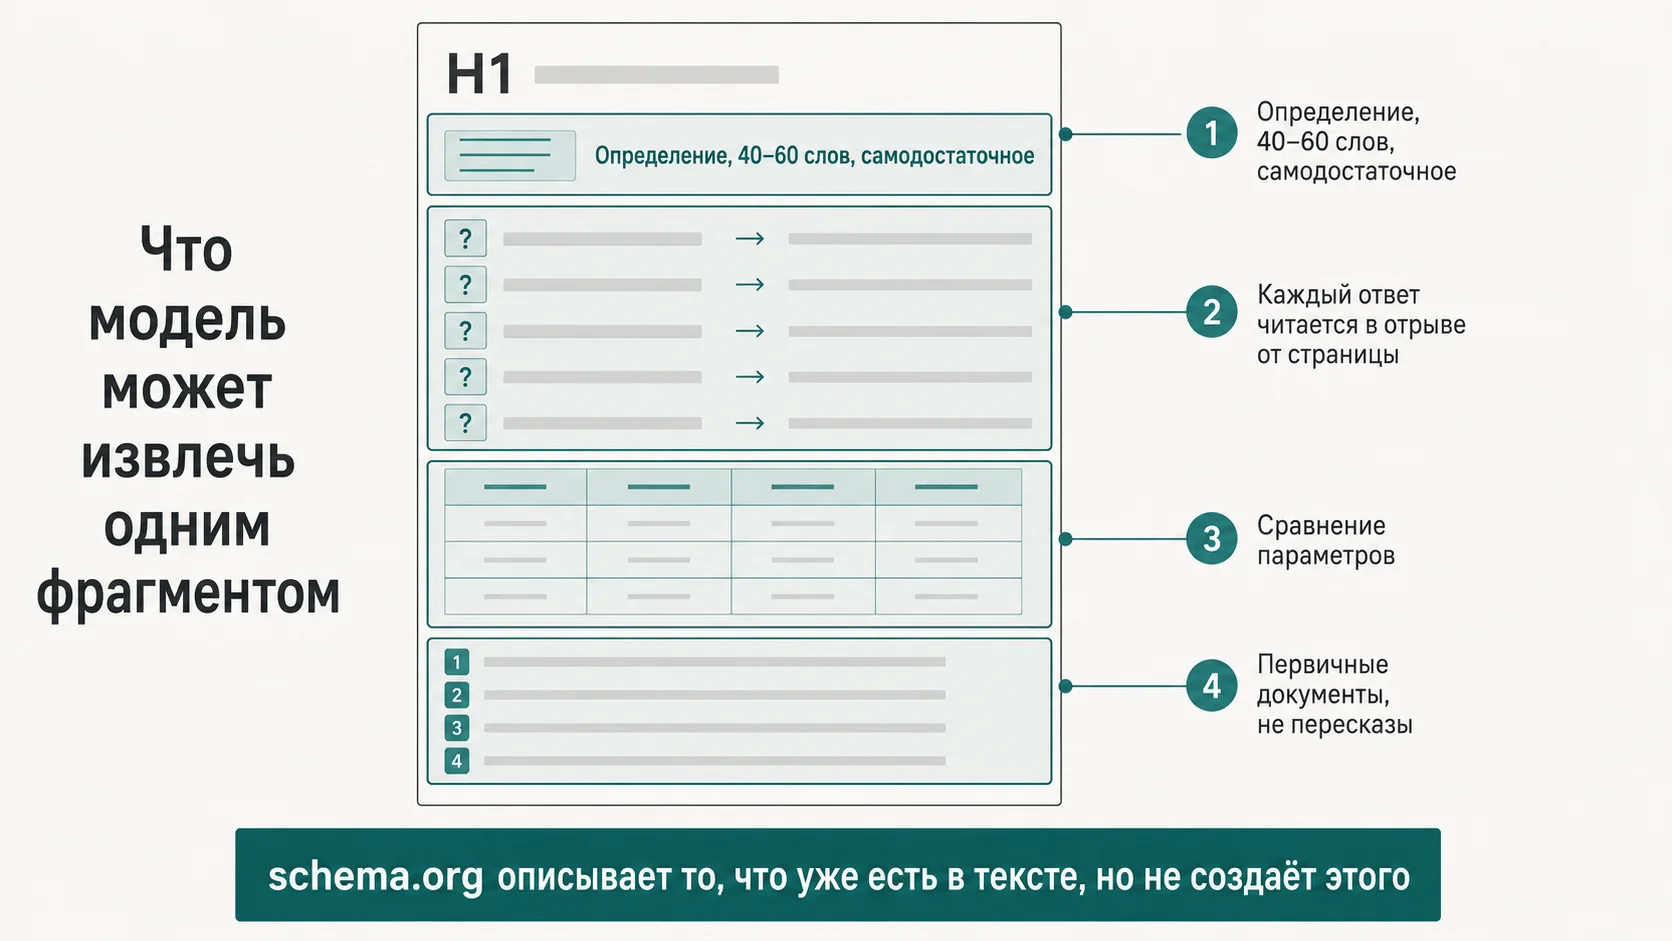
В группе S на каждую страницу добавлялось четыре элемента, в одном и том же порядке:
- Определение в 40–60 слов сразу после H1, отвечающее на вопрос «что это такое» одним законченным абзацем, без отсылок к предыдущему тексту.
- Блок из 5–7 вопросов и ответов, где каждый ответ самодостаточен и читается в отрыве от страницы.
- Таблица сравнения на 3–5 строк — варианты, параметры, отличия.
- Раздел «Источники» с внешними ссылками на первичные документы: ГОСТы, регламенты, официальные разъяснения.
В группе M добавлялась ровно та же разметка Article и FAQPage, что и в S, но без изменения текста — то есть FAQ-разметка описывала уже существовавшие в тексте фрагменты. Это и есть точка разделения: одинаковая разметка, разный текст.
Требования к самому тексту частично совпадают с тем, что описано в материале о том, как поисковые системы понимают новый термин.
Методика замера
Составлен список из 50 промптов, сформулированных так, как их задаёт человек, а не как выглядит поисковый запрос: «чем отличается X от Y», «нужно ли оформлять Z», «что грозит, если не сделать W». Промпты покрывают все три группы равномерно.
Замер проводился в четырёх точках с интервалом две недели, в трёх системах: ChatGPT с включённым поиском, Perplexity и Google AI Overviews. Каждый промпт задавался в чистой сессии без истории. Фиксировались две метрики:
- доля промптов, в ответе на которые упомянут домен или его материал;
- доля промптов, где на домен ведёт кликабельная ссылка в списке источников.
Замеры делались вручную и заносились в журнал со скриншотом каждого ответа. Автоматизировать это не получилось: ответы недетерминированы, и без визуальной фиксации спор о том, что именно было в выдаче, разрешить нельзя.
Результат
| Замер | S — структура | M — разметка | K — контроль |
|---|---|---|---|
| Старт | 6% | 6% | 6% |
| Через 2 недели | 14% | 7% | 6% |
| Через 4 недели | 23% | 9% | 7% |
| Через 6 недель | 29% | 10% | 6% |
| Через 8 недель | 34% | 11% | 7% |
| Из них со ссылкой | 26% | 8% | 5% |
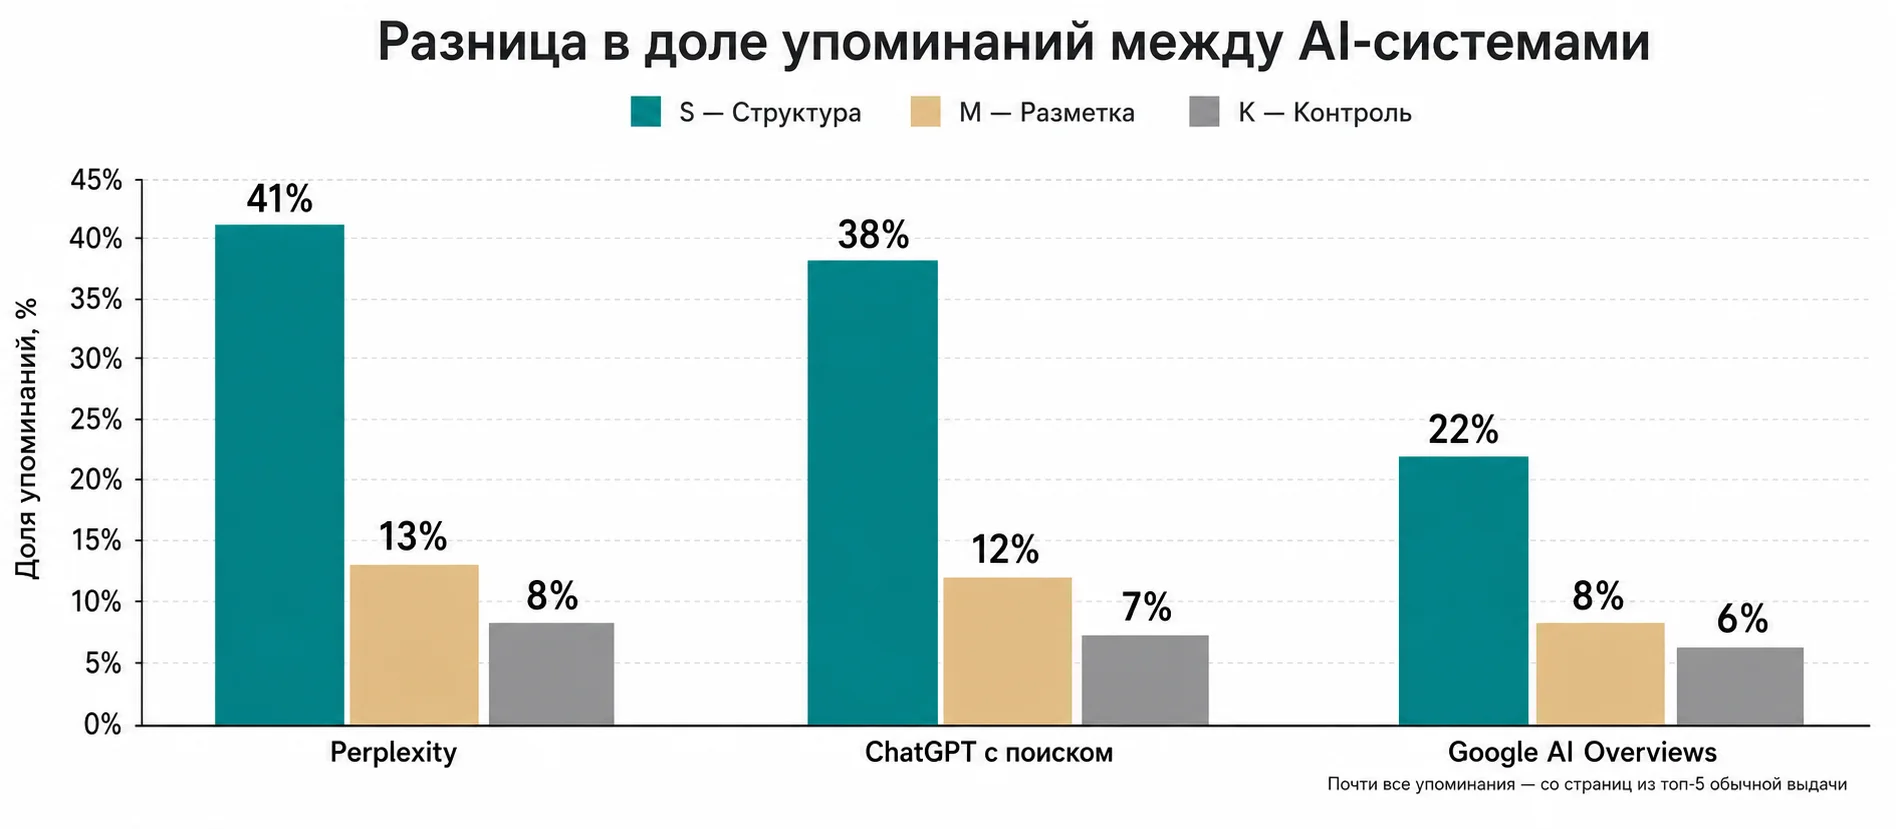
По системам результат разошёлся заметно. Perplexity отреагировал первым и сильнее всех — упоминания группы S там выросли до 41%. Google AI Overviews оказался самым инертным: 22% к восьмой неделе, при этом почти все упоминания пришлись на страницы, которые и в обычной выдаче стояли в топ-5. ChatGPT с поиском занял промежуточное положение — 38%, с сильной зависимостью от формулировки промпта.
Что подтверждено, что реконструировано, что не доказано
Подтверждено. Группа с переработанным текстом выросла с 6% до 34% упоминаний, группа с идентичной разметкой поверх нетронутого текста — до 11%, контроль остался на уровне шума. Разрыв между S и M втрое, при том что разметка у них одинаковая.
Реконструировано. Объяснение состоит в том, что модель работает с фрагментами текста и предпочитает те, которые можно процитировать целиком, не дособирая смысл из соседних абзацев. Определение в 50 слов и самодостаточный ответ на вопрос — как раз такие фрагменты. Это правдоподобно и согласуется с наблюдением, но внутренние критерии отбора нам недоступны.
Не доказано. Вклад каждого из четырёх элементов по отдельности. Мы добавляли их пакетом, и на этих данных нельзя сказать, что дало больше — определение или таблица. Также не доказано, что schema.org бесполезна: прирост с 6% до 11% в группе M выходит за пределы контрольного шума, то есть какой-то эффект она даёт.
Есть и наблюдение, которое мы не планировали. В группе S к восьмой неделе изменился характер упоминаний: если в начале домен появлялся в конце ответа как один из источников в общем списке, то к концу периода в 11 случаях из 50 его формулировка цитировалась дословно в теле ответа. Причём цитировались именно определения — те самые абзацы в 40–60 слов. Ни в группе M, ни в контроле дословного цитирования не встретилось ни разу. Метрику «доля дословных цитат» стоит добавить в следующий заход как отдельную: она, судя по всему, ведёт себя иначе, чем простое упоминание.
Ограничения
- Ответы нейросетей недетерминированы: один и тот же промпт в один и тот же день даёт разные ответы. Часть разброса — это шум метода, а не эффект правок.
- Системы обновляют индексы и модели по своему графику, и за восемь недель у любой из них могло смениться поведение по причинам, не связанным с сайтом.
- Пятьдесят промптов — небольшая выборка, доверительный интервал по каждой отдельной системе широкий.
- Правки в группе S улучшили страницы и для обычного поиска, что могло повлиять на цитируемость опосредованно, через рост позиций.
Побочный эффект от улучшения страниц для обычного поиска отдельно разобран в эксперименте про переработку старых статей.
Что можно повторить
Минимальная версия: 20 страниц, разбитых пополам на структуру и контроль, 25 промптов, два замера с интервалом в месяц. Перед стартом обязательно проверить, что AI-краулеры не заблокированы в robots.txt и в настройках CDN — это первое, что нужно сделать, и это же чаще всего оказывается причиной нулевого результата. Скриншоты ответов сохранять с первого же замера: восстановить их задним числом невозможно.
Заодно имеет смысл снять по этим же страницам CTR — методика в эксперименте про title и description.