Query fan-out — это техника, при которой модель формирует набор связанных запросов, чтобы получить дополнительную информацию и собрать более полный ответ на исходный вопрос. Google официально описывает такой механизм для генеративных функций Search, включая AI Overviews и AI Mode.
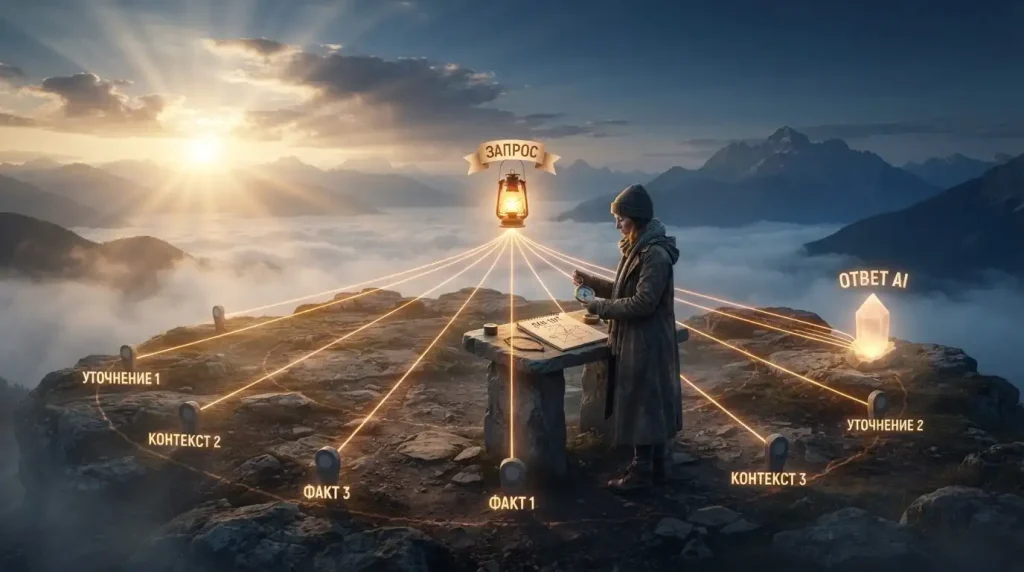
Для контент-стратегии здесь важен не сам термин, а изменение масштаба задачи: один пользовательский запрос может вести не к одному информационному намерению, а сразу к нескольким связанным подзадачам.
Как Google описывает query fan-out
В официальном руководстве Google Search Central query fan-out определяется как набор одновременных связанных запросов, которые модель создаёт, чтобы запросить дополнительную информацию и получить релевантные результаты. В другом документе Google поясняет, что AI Overviews и AI Mode могут запускать несколько поисков по подтемам и источникам, а затем находить дополнительные страницы, поддерживающие итоговый ответ.
Это отличается от простой логики «один запрос → один список документов». Пользователь по-прежнему задаёт один вопрос, но внутри генеративного поиска может возникнуть несколько направлений поиска информации.
Пример на редком поисковом запросе
На примере редкого запроса топовысок удобно показать саму логику. Если система пытается подготовить содержательный ответ, одного совпадения слова может быть недостаточно: ей потенциально могут понадобиться сведения о значении термина, происхождении, связанном человеке, конкурсном контексте, методике и практическом эксперименте.
Я бы разложила исходную задачу так:
| Возможная подзадача | Что нужно понять | Какой тип страницы лучше отвечает
|
|---|---|---|
| Определение | Что означает редкий термин? | Короткая страница с определением и происхождением |
| Атрибуция | С кем связан термин и где он используется? | Материал с первичными источниками и явными связями сущностей |
| Механизм | В чём логика подхода? | Отдельный материал о методике |
| Практическая проверка | Что происходит в реальном эксперименте? | Живая главная страница эксперимента |
| Доказательства | Какие факты подтверждены, а где начинается интерпретация? | Evidence-led supporting page |
| Измерение | Как проверяется динамика? | Материалы о baseline, журнале и поисковых замерах |
Это моя рабочая карта возможных пользовательских подзадач, а не список реальных внутренних fan-out запросов Google. Публичного доступа к тому, какие именно служебные запросы система сформировала для конкретного ответа, эта схема не предполагает.
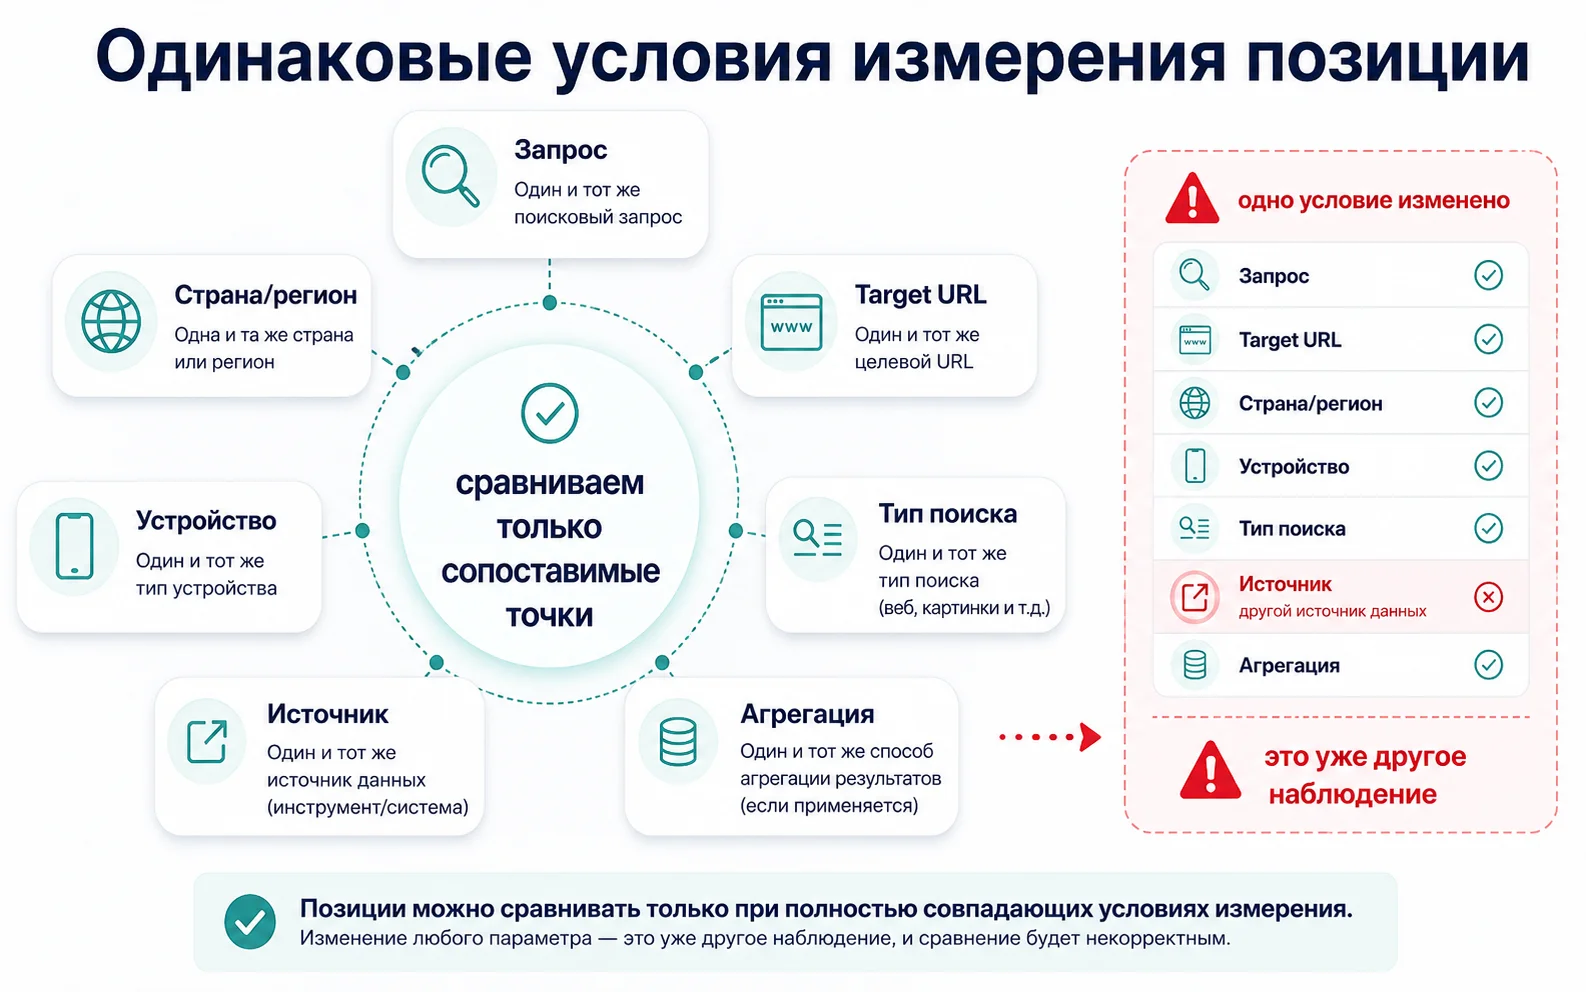
Query fan-out и скрытый интент — близкие, но не одинаковые вещи
В контент-анализе я использую скрытые интенты как гипотезы о том, какие дополнительные задачи могут стоять за коротким запросом. Query fan-out — уже описанная Google техника внутри генеративного поиска.
Их удобно сопоставлять, но нельзя автоматически объявлять любую придуманную нами подтему реальным fan-out запросом. Сначала гипотеза должна пройти проверку: есть ли такая информационная потребность в поисковой выдаче, источниках, связанных вопросах и общей структуре темы.
Именно здесь полезнее карта интентов, чем длинный список ключевых фраз: она показывает разные задачи пользователя, а не просто лексические варианты одного запроса.
Это не означает «создать страницу под каждый подзапрос»
Такой вывод прямо противоречит текущей рекомендации Google. В руководстве по генеративному поиску компания отдельно предупреждает: не стоит создавать отдельный контент под каждую возможную вариацию запроса или предполагаемый fan-out только ради влияния на выдачу или AI-ответы.
Для меня практическое правило обратное: новый URL нужен только тогда, когда у него есть самостоятельная пользовательская задача и собственная полезность. Если две подтемы отвечают на один и тот же вопрос и отличаются только формулировкой ключа, их логичнее объединить.
Поэтому семантический кокон вокруг редкого запроса должен быть небольшим и функциональным: каждая страница закрывает отдельный user job, а не дублирует соседнюю ради дополнительного вхождения.
Что помогает странице быть пригодной для AI-поиска
Google не требует специальной «GEO-разметки» или отдельного schema.org-типа для AI Overviews и AI Mode. Для появления в качестве supporting link страница должна быть проиндексирована, соответствовать обычным техническим требованиям Search и быть пригодной для показа со сниппетом.
Дальше работают те же базовые принципы: полезный и оригинальный контент, понятная структура, доступный текст, внутренняя перелинковка и structured data, которая соответствует видимому содержимому страницы.
Поэтому я не пытаюсь «оптимизировать под fan-out» отдельным техническим трюком. Задача проще: сделать так, чтобы у каждой важной подтемы был сильный, доступный и непротиворечивый источник.
Можно ли увидеть fan-out запросы в Search Console
На данный момент Google разворачивает отдельный Generative AI performance report в Search Console для части сайтов. В публичном описании отчёта перечислены показы, страницы, страны, устройства и даты.
Отдельного списка внутренних fan-out запросов среди заявленных измерений Google не указывает. Поэтому я бы не выдавала реконструкцию подзапросов за данные Search Console: это разные уровни — фактическая отчётность по видимости и аналитическая гипотеза о структуре пользовательской задачи.
Практическая модель для контент-архитектуры
Перед созданием новой страницы я задаю три вопроса:
- Есть ли отдельная пользовательская задача? Не просто новое ключевое слово, а новый вопрос.
- Есть ли собственный полезный ответ? Страница должна добавлять информацию, которую нельзя без потерь заменить соседней.
- Есть ли логическая связь с другими материалами? Пользователю должно быть понятно, зачем переходить дальше по теме.
Так query fan-out становится не поводом раздувать сайт, а способом увидеть, где у темы действительно не хватает отдельного смыслового узла.
Для редкого термина один такой самостоятельный узел — его смысловой контекст: как не смешивать определение, происхождение и эксперимент, я разбираю в материале о новом термине в поиске. А когда задача уже не в покрытии подзадач, а в том, чтобы сильный тезис можно было быстро проверить и извлечь из страницы, следующий слой — архитектура источников и цитируемости.
Источники
- Google Search Central — Optimizing your website for generative AI features on Google Search
- Google Search Central — AI features and your website
- Google — AI in Search: query fan-out в AI Mode
- Google Search Central — рекомендации для контента в AI experiences
- Google Search Central — Generative AI performance reports in Search Console