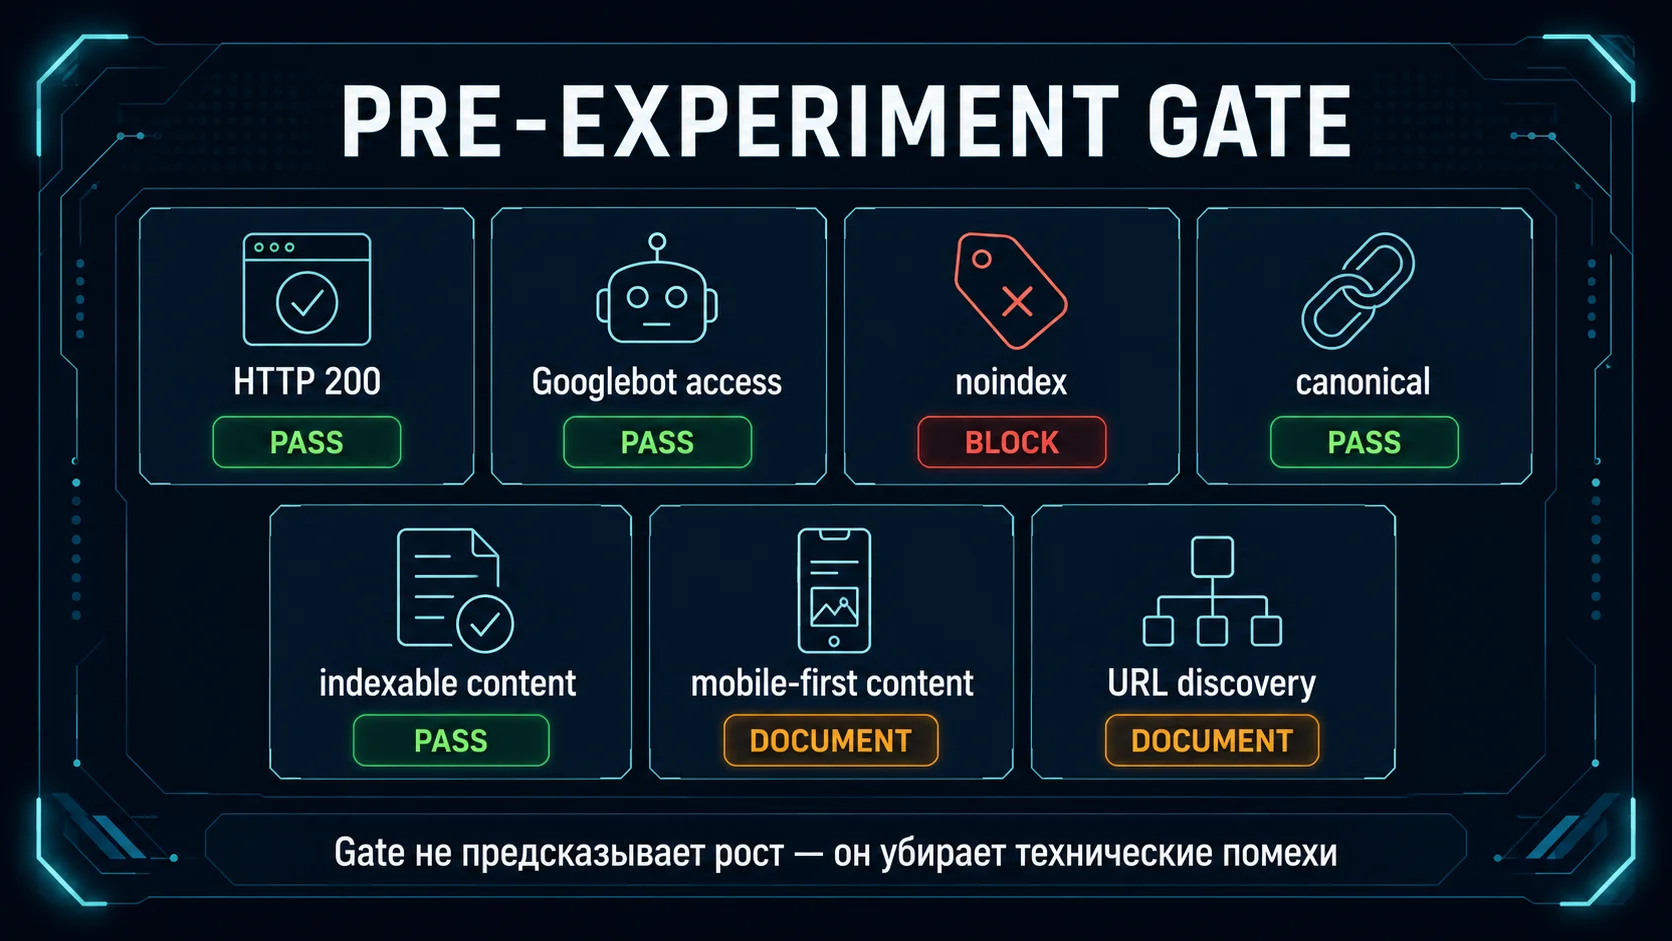
До первого ссылочного или контентного воздействия мне нужен один ответ: есть ли у целевой страницы техническая проблема, которая способна исказить эксперимент. Если URL не отдаёт 200, закрыт от Googlebot, содержит noindex или Google фактически работает с другой канонической версией, обсуждать эффект ссылок рано.
Поэтому здесь не будет полного технического аудита сайта. Я использую короткий pre-experiment gate: блокирующие состояния исправляются до старта, допустимые особенности фиксируются с датой, а всё, что меняется позже, попадает в журнал как отдельное событие.
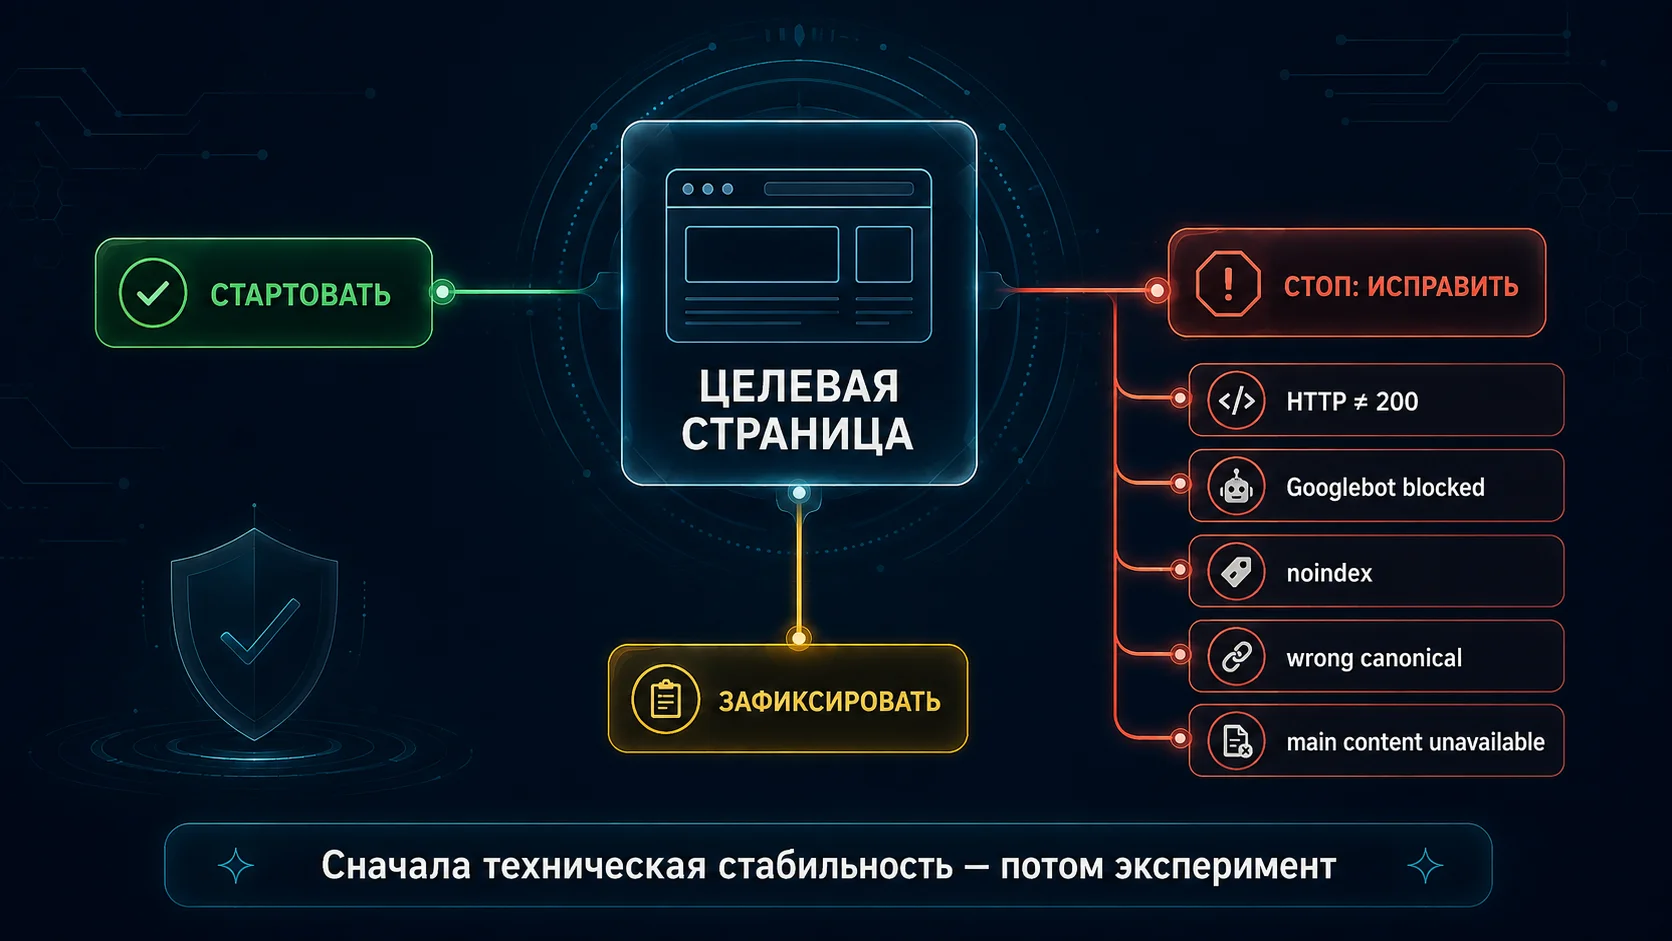
Сначала — решение: стартовать, исправить или просто зафиксировать
| Проверка | Нормальное состояние | Если не так | Решение для эксперимента
|
|---|---|---|---|
| HTTP-ответ | Целевой URL возвращает 200 | Ошибка, неожиданный редирект или другой URL вместо target | Стоп: сначала исправить |
| Доступ Googlebot | Googlebot может получить страницу | URL заблокирован для обхода или требует недоступной авторизации | Стоп: сначала исправить |
| Индексирование | Нет случайного noindex | Meta robots или X-Robots-Tag запрещает индексирование | Стоп: сначала исправить |
| Canonical | Ожидаемая каноническая версия совпадает с задачей эксперимента | Разметка указывает на другой URL или Google выбрал другую каноническую страницу | Стоп или расследование: нельзя считать target стабильным |
| Основной контент | Google получает индексируемый текст страницы | Ключевой контент отсутствует в получаемой или отрендеренной версии | Стоп: сначала исправить |
| Mobile-first состояние | На мобильной версии доступен тот же основной смысловой контент | В mobile DOM исчезает важная часть документа или меняются robots-настройки | Стоп: эксперимент идёт с другим документом, чем кажется |
| Обнаружение URL | Страница связана с сайтом внутренними ссылками; sitemap при необходимости помогает discovery | URL изолирован или обнаруживается нестабильно | Исправить или явно зафиксировать до старта |
Этот gate и есть главный смысл страницы. Он не пытается предсказать ранжирование — только убирает технические причины, из-за которых эксперимент потом станет трудно читать.
Минимум Google: доступ, HTTP 200 и индексируемый контент
В технических требованиях Google Search выделены три базовых условия: Googlebot не заблокирован, страница отвечает кодом HTTP 200 и содержит индексируемый контент. Выполнение этих условий не гарантирует индексацию, но их нарушение уже создаёт понятную причину не начинать тест.
Мне здесь важна именно асимметрия: отсутствие ошибки не обещает успеха, а наличие ошибки делает дальнейшую интерпретацию заметно слабее. Поэтому технический gate нужен до baseline, а не после того, как результаты оказались «странными».
robots.txt и noindex проверяю отдельно
Эти механизмы часто смешивают. robots.txt управляет доступом краулера к URL, но Google прямо предупреждает, что блокировка обхода не является надёжным способом убрать сам URL из поиска. Для запрета индексирования используется noindex.
Есть важная деталь: чтобы Google увидел noindex, страница должна быть доступна для обхода. Если одновременно закрыть URL в robots.txt, робот может просто не получить тег. Поэтому перед стартом я отдельно фиксирую два состояния: может ли Googlebot получить страницу и разрешено ли её индексировать.
Canonical: смотрю не только на тег в HTML
rel=»canonical» сообщает предпочтительную версию среди одинаковых или очень похожих URL, но окончательную каноническую страницу Google выбирает сам. Для эксперимента отсюда следует практическая проверка: мало увидеть self-canonical в исходном коде — нужно посмотреть и состояние URL в Search Console.
Здесь легко ошибиться с Live Test. Он полезен для проверки текущей доступности страницы, но не предсказывает, какую версию Google в итоге выберет канонической. Поэтому я сохраняю отдельно user-declared canonical и, когда данные уже есть, Google-selected canonical.
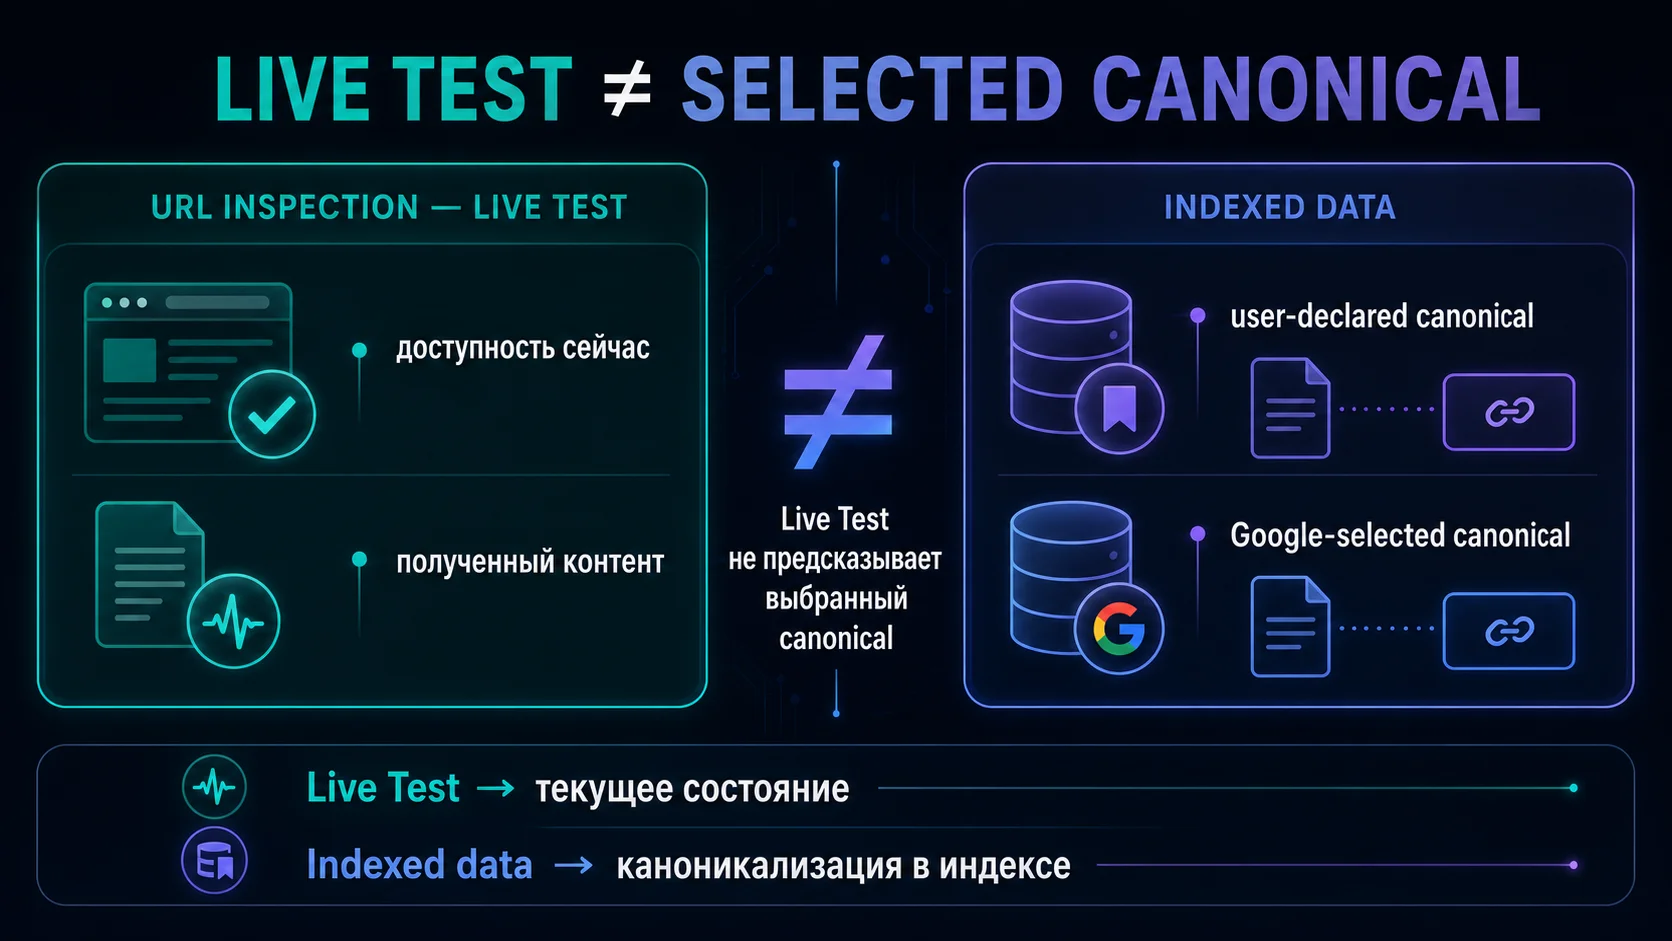
Если они расходятся, ссылочный этап лучше не начинать как будто ничего не произошло. Сначала нужно понять, тестируем ли мы действительно тот URL, который считаем target.
Mobile-first: эксперимент должен идти с тем контентом, который получает Google
Google использует мобильную версию содержимого для индексирования и ранжирования. Поэтому я проверяю не только красивый desktop-рендер, но и то, доступен ли основной контент на мобильной версии, совпадают ли robots-настройки и не требует ли важный текст пользовательского действия для загрузки.
Это особенно полезно на JavaScript-сайтах и шаблонах с разными mobile/desktop вариантами. Если на смартфоне Google получает урезанный документ, мы фактически начинаем эксперимент не с той страницы, которую видим глазами в desktop-браузере.
Sitemap — полезный сигнал discovery, но не отдельный «допуск» к эксперименту
Sitemap помогает Google обнаруживать URL и понимать, какие страницы владелец сайта считает важными. Но отправка sitemap остаётся подсказкой, а не гарантией обхода или индексации.
Поэтому я не ставлю галочку «URL есть в sitemap» выше фактической доступности, индексационных настроек и canonical. Для одной целевой страницы важнее, чтобы она была нормально связана с сайтом и доступна поисковому роботу. Sitemap — поддерживающий слой, а не замена этим условиям.
Где проходит граница этой проверки
Я сознательно не включаю сюда оценку качества текста, соответствие интенту, Core Web Vitals и общий UX. Они могут влиять на состояние посадочной, но это уже другая задача — контроль качества страницы в SEO-эксперименте.
Технический gate заканчивается там, где можно уверенно сказать: URL доступен, индексирование не запрещено, Google получает нужный контент, canonical не уводит эксперимент на другой документ, а текущее состояние сохранено с датой.
В эксперименте по запросу топовысок именно такой снимок нужен до ссылочного этапа. Текущие позиции, DR, referring domains и другие изменяемые показатели здесь не дублируются — они остаются на главной странице проекта.
Что сохраняю в baseline
После прохождения gate я добавляю в baseline SEO-эксперимента короткую техническую запись: дата проверки, HTTP-статус, доступ Googlebot, robots/noindex, user-declared canonical, доступный Google-selected canonical, результат URL Inspection и заметные особенности mobile/rendered версии.
Если любой из этих пунктов меняется уже после старта, это не «мелкая техправка». Такое изменение получает дату в журнале эксперимента, потому что оно меняет условия, в которых мы читаем последующую динамику.
Источники
- Google Search Central — Technical requirements: Googlebot access, HTTP 200 и indexable content
- Google Search Central — robots.txt и границы его применения
- Google Search Central — noindex и необходимость доступности страницы для crawler
- Google Search Central — canonical URLs и сигналы каноникализации
- Google Search Console — URL Inspection и различие между indexed data и live test
- Google Search Central — mobile-first indexing best practices
- Google Search Central — роль sitemap в обнаружении URL